

Text Embeddings Reveal (Almost) As Much As Text
Paper • 2310.06816 • Published • 1
Ce modèle est le correcteur de la chaîne vec2text : à partir du vecteur cible, du vecteur de l'hypothèse
courante, de leur différence (trois jeux de 8 pseudo-tokens) et du texte de l'hypothèse, il génère une version
corrigée. Appliqué en boucle avec une recherche en faisceau et un re-classement par similarité cosinus (le
vecteur de chaque candidat est recalculé avec Qwen/Qwen3-Embedding-0.6B), il fait passer la reconstruction
de phrases courtes de 19 % à 48 % de phrases exactes. Il s'utilise avec l'inverseur
fenyo/vec2text-qwen3-fr-inverter-32 (profil short).
Code, documentation complète (en français) et scripts d'entraînement : https://github.com/AlexandreFenyo/vec2text-qwen3-fr.
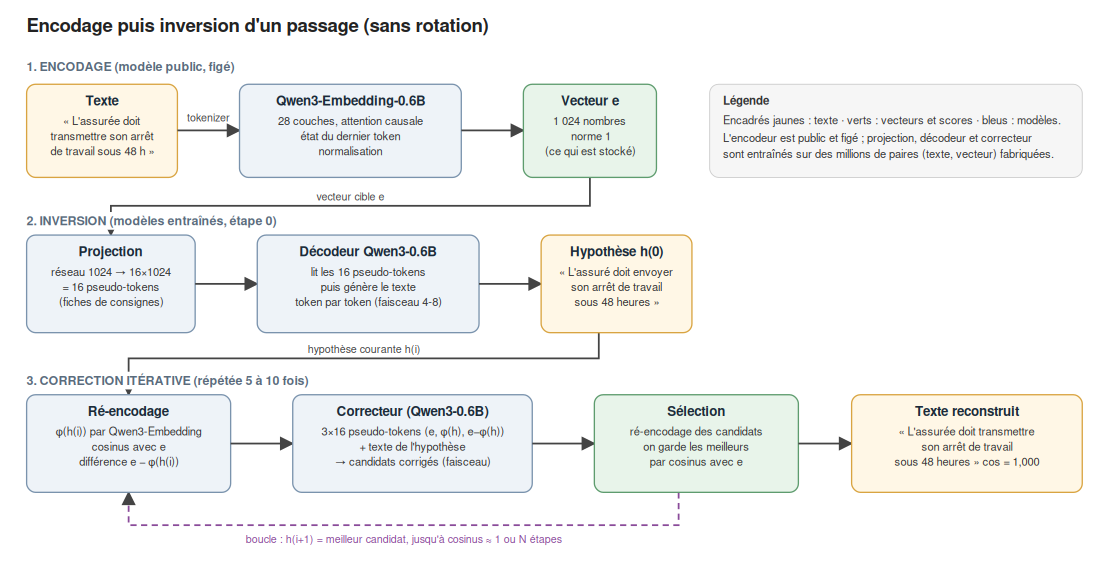
Le correcteur reçoit la séquence [pseudo-tokens de e] [pseudo-tokens de φ(h)] [pseudo-tokens de e − φ(h)] tokens de h <|im_start|> et génère le texte corrigé ; e est le vecteur cible, h l'hypothèse courante, φ l'encodeur. Les poids du
décodeur (Qwen3-0.6B-Base, 28 couches) sont entièrement réentraînés par descente de gradient sur des paires
(texte, vecteur) fabriquées avec l'encodeur public ; l'encodeur lui-même n'est pas modifié.
Version v3 : correcteur initialisé depuis une première version, réentraîné 2 époques sur 2,14 M de triplets (vecteur, hypothèse, texte vrai) dont les hypothèses ont été produites par l'inverseur sur des passages qu'il n'avait jamais vus (1,74 M de nouveaux passages généraux, 150 k du domaine, 400 k réservés). Cette condition est décisive : entraîné sur des hypothèses de passages déjà vus par l'inverseur, trop bonnes, le correcteur apprend à recopier (BLEU 48,7 à 5 étapes contre 62,8 ici). AdamW, lots de 128, 3 h 30 sur une RTX 5090, perte de validation 1,07 → 0,94.
| Configuration (300 phrases de test ≤ 32 tokens, avec l'inverseur v2) | BLEU | F1 tokens | Exact | Cosinus |
|---|---|---|---|---|
| 1 étape, faisceau 4 | 48,1 | 81,0 % | 33 % | 0,965 |
| 5 étapes, faisceau 4 | 62,8 | 86,8 % | 43 % | 0,978 |
| 10 étapes, faisceau 8 | 72,4 | 90,0 % | 48 % | 0,985 |
| test santé / sécurité sociale, 10 étapes, faisceau 8 | 78,9 | 92,8 % | 42 % | 0,993 |
BLEU et F1 mesurent le recouvrement avec le texte d'origine ; « exact » est la part de textes reproduits à l'identique ; le cosinus est la similarité entre le vecteur du texte reconstruit et le vecteur d'entrée.
Avec l'outil du dépôt (téléchargement automatique des modèles) :
git clone https://github.com/AlexandreFenyo/vec2text-qwen3-fr.git && cd vec2text-qwen3-fr
.venv/bin/python embed.py --texts phrases.txt --out vecs.tsv --metadata meta.tsv
.venv/bin/python invert.py --vectors vecs.tsv --metadata meta.tsv --profile short --steps 5 --beam 4 --out resultat.tsv
Chargement direct en Python (classe Vec2TextQwen du dépôt) :
from huggingface_hub import snapshot_download
from v2t.model import Vec2TextQwen
m = Vec2TextQwen.load(snapshot_download("fenyo/vec2text-qwen3-fr-corrector-32"))   # bfloat16, GPU
# inverseur : m.generate(e)  ; correcteur : m.generate(e, e_hyp, hyp_ids)   (voir v2t/infer.py)
Fichiers : model.safetensors (décodeur, bfloat16), proj.pt (projections des vecteurs en pseudo-tokens),
v2t_config.json (n_prefix = 8, max_tokens = 32, corrector = true).
Modèle associé : fenyo/vec2text-qwen3-fr-inverter-32.
Ce modèle reconstruit du texte à partir de vecteurs d'embeddings ; il sert à mesurer le risque de fuite d'une base vectorielle et à tester les protections (dé-identification des textes, rotation secrète des vecteurs), décrites dans le dépôt. Il ne doit pas être utilisé pour reconstruire des données personnelles à partir de vecteurs dont on n'est pas légitimement détenteur. Les textes d'exemple du dépôt sont synthétiques. Qualité mesurée sur du français général et des textes de santé / sécurité sociale ; non évaluée sur d'autres langues ni sur des vecteurs produits avec une instruction de requête ou tronqués (Matryoshka).
J. X. Morris, V. Kuleshov, V. Shmatikov, A. M. Rush. Text Embeddings Reveal (Almost) As Much As Text. EMNLP 2023. arXiv:2310.06816. Les choix d'ingénierie, les mesures et la règle de protection sont décrits dans https://github.com/AlexandreFenyo/vec2text-qwen3-fr.
Base model
Qwen/Qwen3-0.6B-Base