

Russian OCR
Collection
5 items • Updated
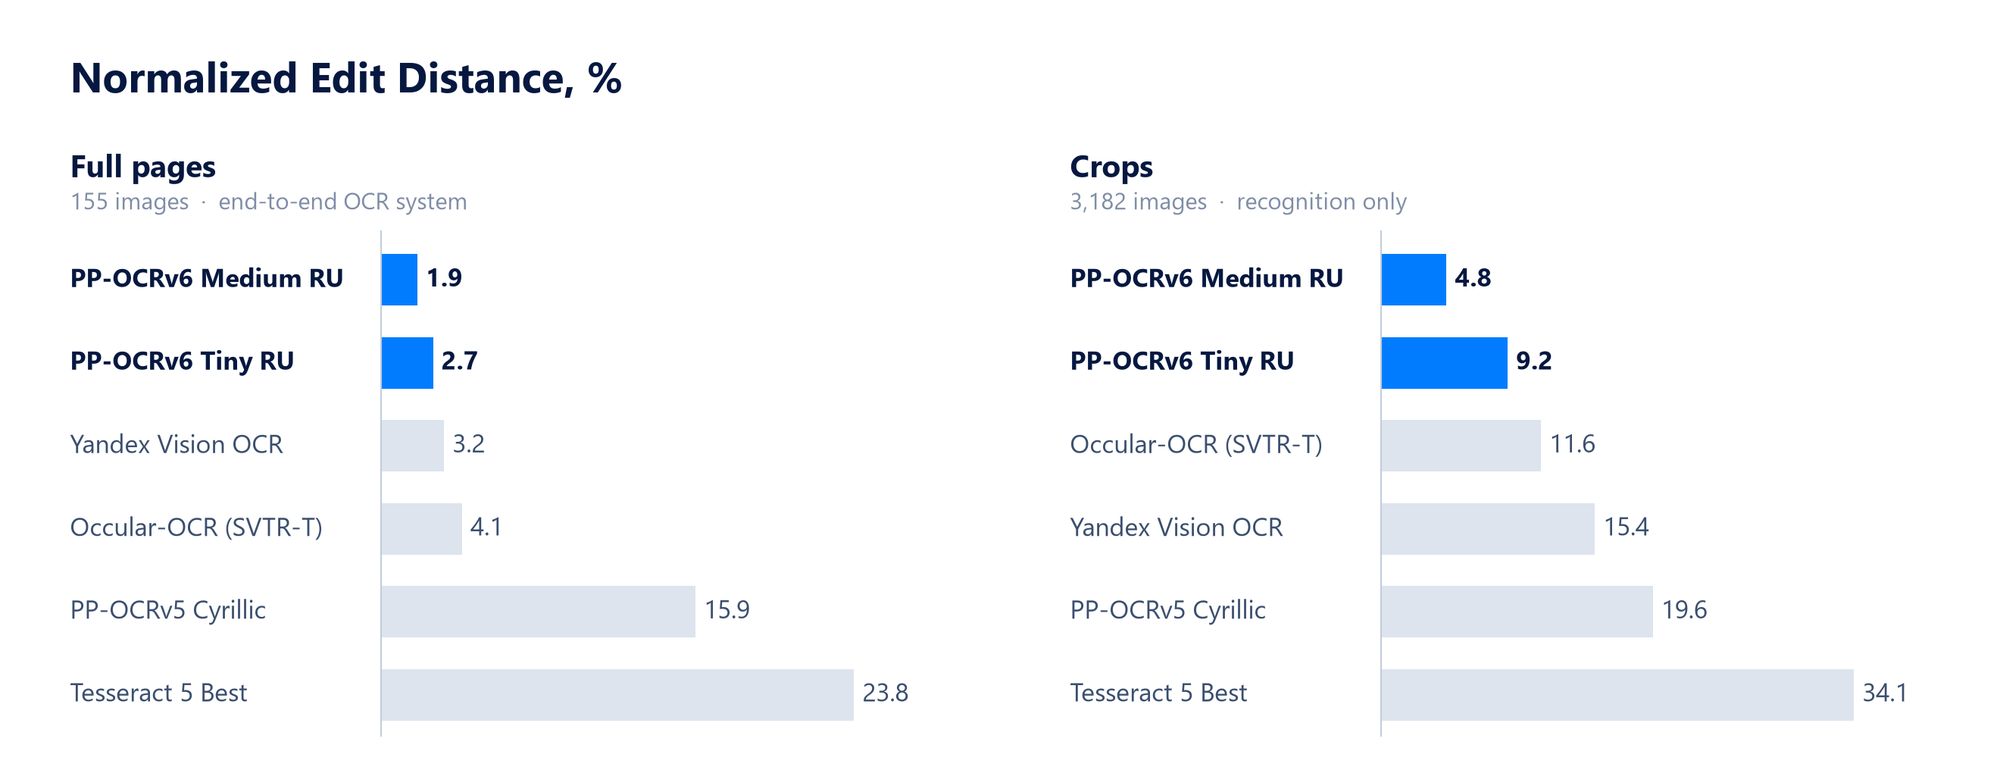
Результаты на ru-ocr-benchmark-hard — бенчмарке со сложными примерами, включая искажения, дефекты печати и изображения низкого качества.
Установка
pip install paddleocr huggingface_hub
pip install paddlepaddle-gpu #Для GPU запуска
Запуск полного пайплайна (Детекция + Распознавание)
from huggingface_hub import snapshot_download
from paddleocr import PaddleOCR

# Скачивание модели
model_dir = snapshot_download(repo_id="metrika-labs/PP-OCRv6_tiny_rec_ru")

# Инициализация (детекция стандартная Paddle PP-OCRv6, распознавание русское)
ocr = PaddleOCR(
    text_recognition_model_name="PP-OCRv6_tiny_rec",
    text_recognition_model_dir=model_dir,
    text_detection_model_name="PP-OCRv6_small_det",
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False
)

# Настройка паддинга для распознавания текста
pipe = getattr(ocr.paddlex_pipeline, "_pipeline", ocr.paddlex_pipeline)
resize_op = pipe.text_rec_model.pre_tfs["ReisizeNorm"]
_orig_resize = resize_op.resize_norm_img
resize_op.resize_norm_img = lambda img, r: _orig_resize(
    img, min(max(r, 1.5 * img.shape[1] / img.shape[0]), resize_op.max_imgW / 48)
)

# Распознавание документа
results = ocr.predict("document.jpg")
for res in results:
    for text, score in zip(res["rec_texts"], res["rec_scores"]):
        print(f"{text} ({score:.4f})")
PP-OCRv6 Tiny — самая лёгкая модель в линейке легковесных распознавателей текста PaddlePaddle. Дообучена для русского языка на 2 млн изображений текстовых строк из реальных сканов документов, рукописных образцов и синтетических данных. Доступна для PaddleOCR, а также в формате ONNX для быстрого инференса на CPU через RapidOCR.
Текущая версия уверенно распознаёт разборчивый рукописный текст, однако при работе со скорописью и менее чётким почерком возможны неточности. В следующем релизе будут устранены характерные для архитектуры PP-OCR ограничения. Данных для обучения станет в разы больше, а качество распознавания рукописного текста заметно улучшится.
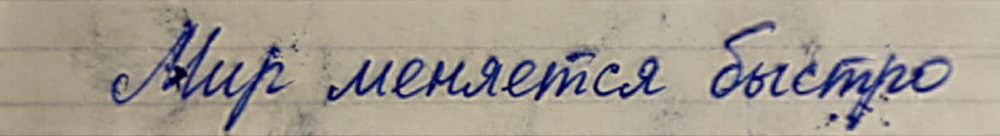
PP-OCRv6 Medium: Мир меняется быстро (score: 0.9765)
PP-OCRv6 Tiny: чир меняется быстро (score: 0.9082)
Стандартные аугментации при обучении модели дополнялись собственным пайплайном: metrika-labs/Document-Augmentations
Бенчмарк для проверки качества моделей: metrika-labs/ru-ocr-benchmark-hard
Часть примеров рукописи из AntiplagiatCompany/HWR200
Оригинальный репозиторий PaddleOCR: PaddlePaddle/PaddleOCR
Фреймворк RapidOCR: RapidAI/RapidOCR
Base model
PaddlePaddle/PP-OCRv6_tiny_rec